Catégorie : SQL

  • « On attend, on ne sait pas ce qui se passe » : enquête sur un verrou SQL

    « Cédric, on attend, on ne sait pas ce qui se passe. »

    C’est par cette phrase qu’un client m’a parlé de son logiciel de gestion. Tous les jours, ses utilisateurs validaient une action, puis attendaient. Sans savoir pourquoi.

    L’application tourne sur SQL Server. Je suis donc allé voir dans le moniteur d’activité. Le 31 juillet, il affichait 15 tâches en attente… pour 3 utilisateurs connectés.
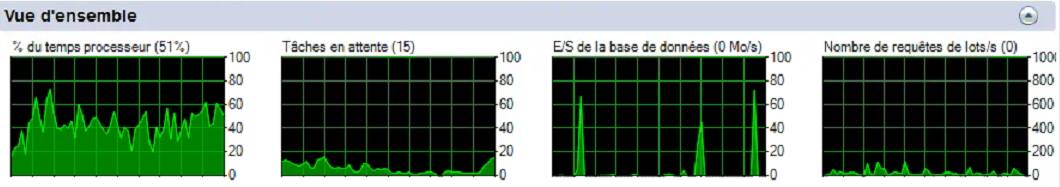
    Un problème de verrou. Imaginez trois personnes qui attendent le même dossier : tant que l’une le garde, les autres ne peuvent rien faire. Ce n’était pas le seul problème du serveur, mais c’est celui qui expliquait l’attente à chaque validation.

    D’abord, remettre de l’ordre dans l’atelier

    J’ai commencé par une analyse de performance, pour faire baisser la charge du processeur et le nombre de requêtes : des index ajoutés, des paramètres du serveur revus, la base temporaire réorganisée.

    Ensuite, le matériel

    J’ai fait ajouter de la mémoire, avec une règle simple : assez de mémoire pour que la base tienne entière en mémoire. Et j’ai déplacé les fichiers de la base temporaire (tempdb) sur un disque SSD, ce que Microsoft recommande d’ailleurs : la base temporaire doit être sur un stockage rapide.

    Le lendemain matin, la capture du moniteur affichait 6 tâches en attente.
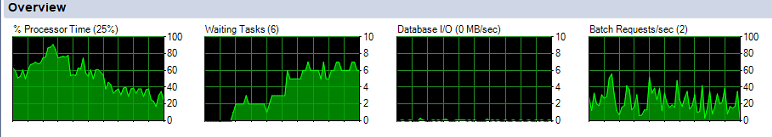
    Le client a vu la différence sur beaucoup d’actions. Mais l’attente à la validation, elle, persistait. On avait de meilleurs outils, le dossier restait bloqué.

    Changement de casquette

    Un verrou dans un logiciel du commerce, ce n’est plus mon terrain : c’est celui de l’éditeur. Encore fallait-il prouver à son prestataire que le serveur n’était pas en cause. J’avoue, ça a été long. J’ai fini par le convaincre d’installer la base sur l’un de ses propres serveurs et de la tester en conditions réelles, avec plusieurs utilisateurs en même temps.

    Trois heures avec le support de l’éditeur

    Une fois le prestataire convaincu, nous avons eu accès au niveau 3 du support de l’éditeur. Trois heures d’intervention. Je n’ai pas eu tous les détails, mais voici ce que j’ai retenu :

    • en personnalisant la base, le prestataire avait rendu certains champs obligatoires, et ces contraintes bloquaient ;
    • enregistrer des documents dans la base de données est déconseillé (pour des fichiers de plus de 1 Mo en moyenne, Microsoft conseille d’ailleurs de les ranger dans le système de fichiers avec FILESTREAM plutôt que dans les tables) ;
    • et le passage à SQL Server 2019 était recommandé.

    Un mois plus tard
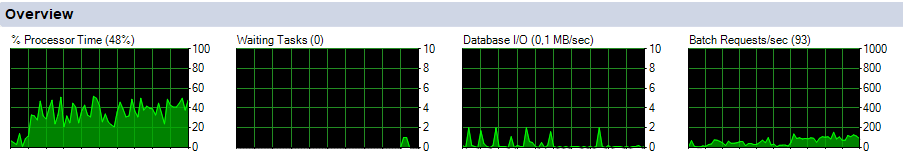
    Zéro tâche en attente sur la capture, et 93 requêtes par seconde traitées. L’attente n’a pas totalement disparu, mais elle ne gêne plus le travail de personne. Et surtout, la facturation se fait sans demander à tout le monde de se déconnecter.

    La leçon que j’en garde : quand le serveur a été remis d’aplomb et que l’attente reste, il faut arrêter d’ajouter de la mémoire et aller chercher l’éditeur.
    Sources

  • Mesurer vraiment la vitesse de tes disques

    Mesurer vraiment la vitesse de tes disques

    Après des mois de tests, j’ai abandonné CrystalDiskMark.

    Diskspd de Microsoft fait mieux le travail. Le résultat est moins joli à regarder, mais les chiffres sont plus proches de la réalité. Et au final, c’est ce qui compte.

    L’installation en 30 secondes

    Ouvre PowerShell et colle ça :

    $client = New-Object System.Net.WebClient
    $client.DownloadFile("https://github.com/Microsoft/diskspd/releases/latest/download/DiskSpd.zip","$env:temp\DiskSpd-download.zip")
    Expand-Archive -LiteralPath "$env:temp\DiskSpd-download.zip" C:\DISKSPD
    cd \diskspd\amd64
    

    C’est fait. Maintenant tu peux mesurer.

    Le test de base

    Voici ma commande pour un test rapide et représentatif :


    ## Pour SQL Server
    
    Si tu as un serveur SQL, les tests changent. Le disque des logs et celui des données tempdb ont des besoins différents.
    
    ### Disque pour les logs de transaction
    ```
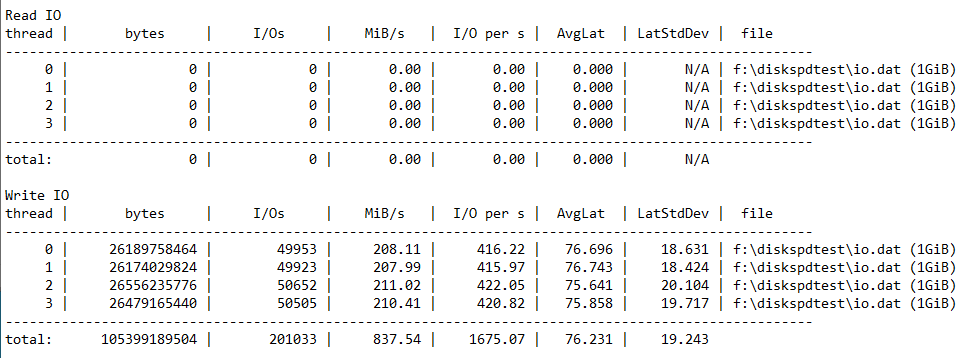
    .\diskspd -b60K -d60 -h -L -o32 -t4 -s -w100 -c1G f:\diskspdtest\io.dat > ..\Log-DiskF.txt
    ```
    
    100% d'écritures séquentielles. C'est exactement ce que fait SQL avec ses logs.
    
    ### Disque pour tempdb
    ```
    .\diskspd -b512K -d120 -h -L -o32 -t4 -si -w100 -c1G f:\diskspdtest\io.dat > ..\Temp-DiskF.txt
    ```
    
    Des blocs plus gros, un test plus long. Tempdb travaille différemment.
    
    ### Test de lecture pure
    ```
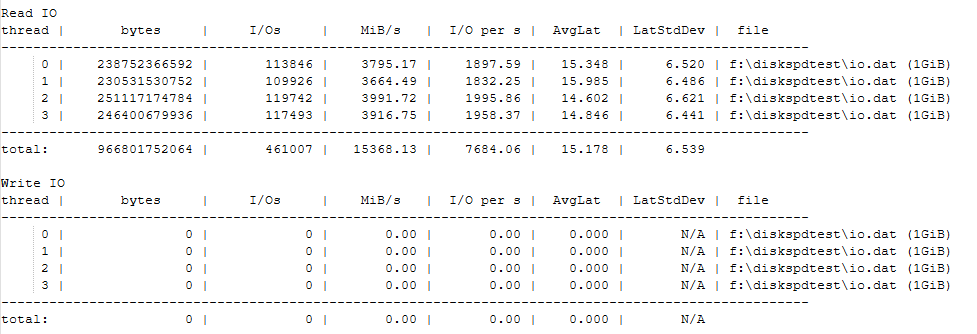
    .\diskspd -b2M -d60 -o32 -h -L -t4 -W -w0 f:\diskspdtest\io.dat > ..\Read-DiskF.txt
    

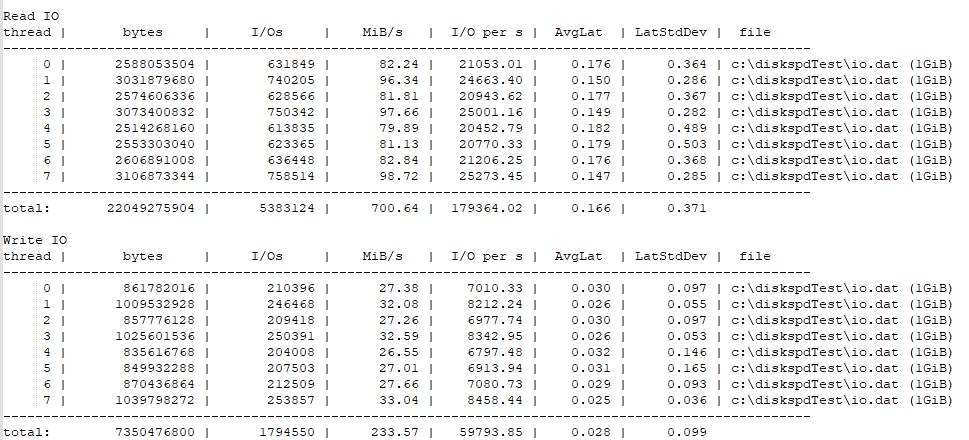
    Sur mon poste avec un NVMe, ça donne des résultats qui correspondent à ce que je vois vraiment quand je travaille.

    Décoder les paramètres

    Le truc avec diskspd, c’est que chaque paramètre compte. Voici ce que j’utilise :

    -b : Taille de bloc (ici 4K, parfait pour SQL Server)
    -d : Durée en secondes (30-60 secondes suffisent)
    -o : Profondeur de file d’attente par thread
    -t : Nombre de threads
    -h : Désactive les caches (essentiel pour tester vraiment)
    -r : Test aléatoire (sinon c’est séquentiel)
    -w : Pourcentage d’écritures (25 = 25% écritures, 75% lectures)
    -Z : Taille du tampon avec données aléatoires
    -L : Capture la latence (indispensable)
    -c : Crée le fichier de test

    N’oublie pas de créer ton dossier de test sur chaque disque :

    md f:\diskspdtest 
    

    Pour SQL Server

    Si tu as un serveur SQL, les tests changent. Le disque des logs et celui des données tempdb ont des besoins différents.

    Disque pour les logs de transaction

    .\diskspd -b60K -d60 -h -L -o32 -t4 -s -w100 -c1G f:\diskspdtest\io.dat > ..\Log-DiskF.txt
    

    100% d’écritures séquentielles. C’est exactement ce que fait SQL avec ses logs.

    Disque pour tempdb

    .\diskspd -b512K -d120 -h -L -o32 -t4 -si -w100 -c1G f:\diskspdtest\io.dat > ..\Temp-DiskF.txt
    

    Des blocs plus gros, un test plus long. Tempdb travaille différemment.

    Test de lecture pure


    .\diskspd -b2M -d60 -o32 -h -L -t4 -W -w0 f:\diskspdtest\io.dat > ..\Read-DiskF.txt

    Blocs de 2MB, zéro écriture. Les valeurs de write seront à 0, c’est normal.

    Ce qui compte vraiment

    Il existe des centaines de combinaisons possibles. Le secret ? Tester ce qui correspond à ton usage réel.

    Veeam a ses propres tests pour la sauvegarde. SQL Server a ses patterns spécifiques. Ne teste pas au hasard : teste ce que tu fais vraiment.

    Deux exemples du terrain

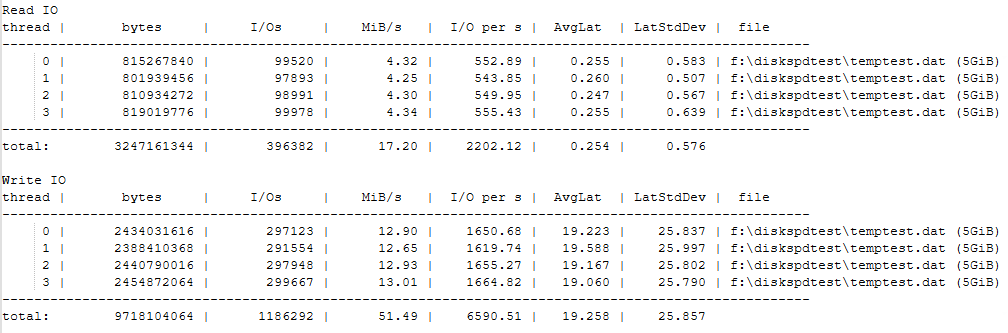
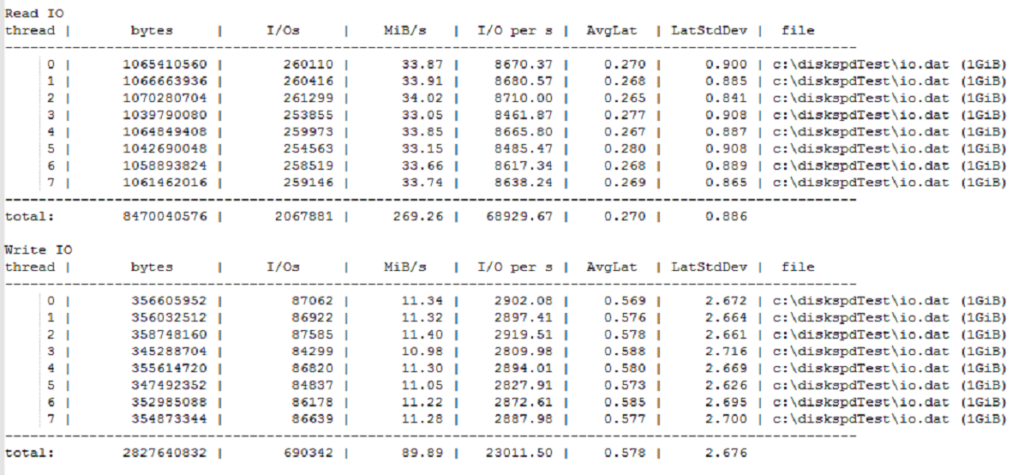
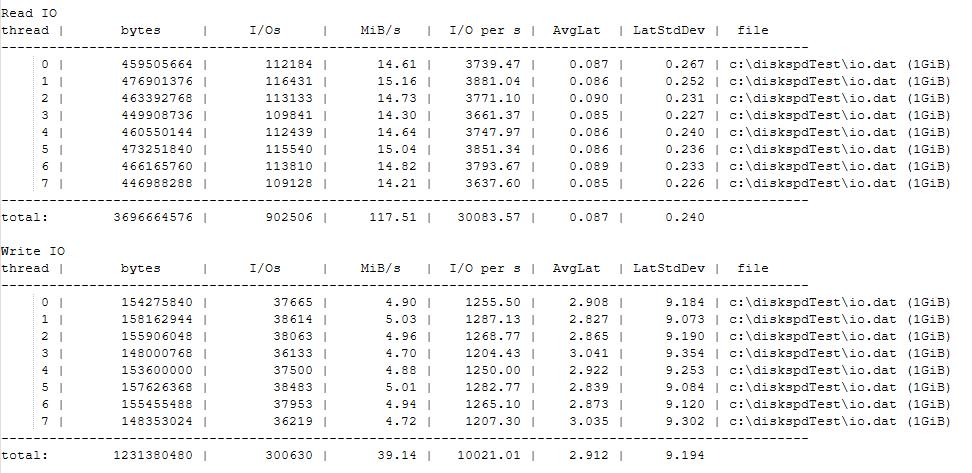
    VMware avec une carte RAID mal configurée

    Avant : performances catastrophiques


    Après : multiplication par 10

    C’est énorme. Mais ça montre surtout qu’une mauvaise config coûte cher.

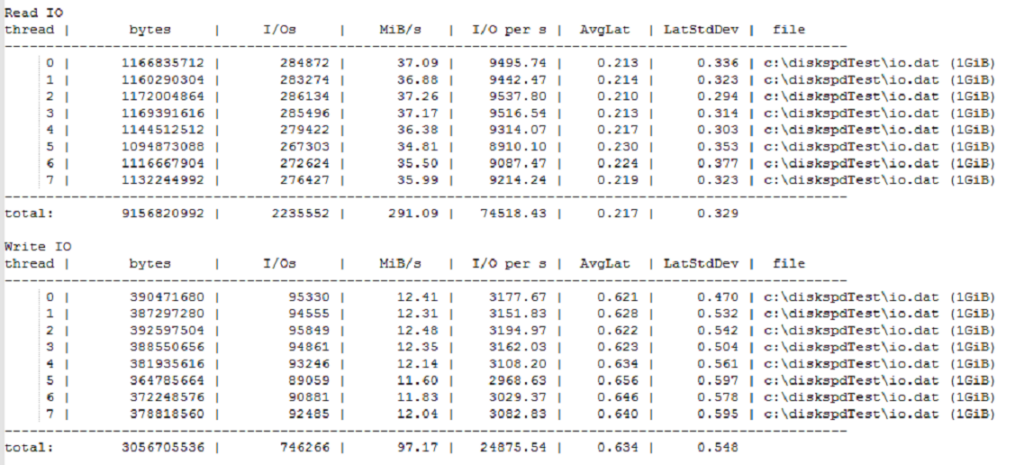
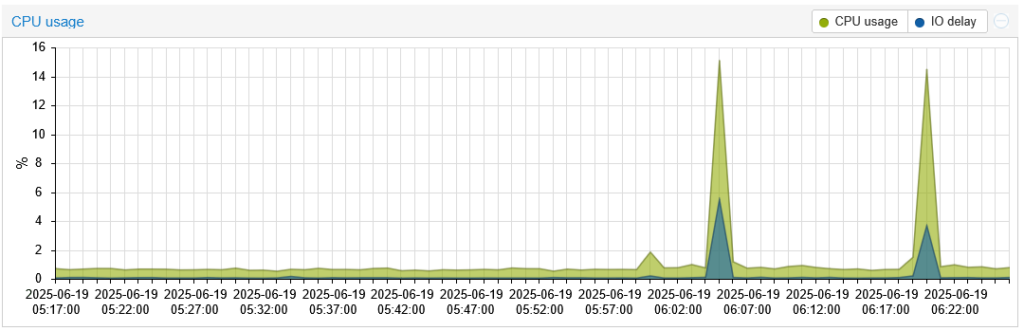
    Proxmox avec RAID ZFS

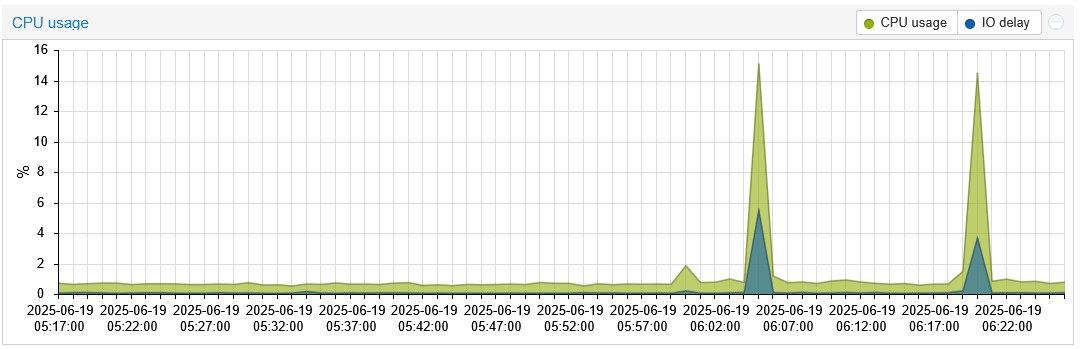
    Mon HP MicroServer Gen11. Serveur de préparation, quasi inactif. Pourtant, deux tests diskspd ont suffi pour charger le système.

    Par contre en échange d’une charge processeur

    Comprendre la latence

    Je m’inspire de Paul Randal pour interpréter les résultats :

    • Excellent : < 1ms
    • Très bon : < 5ms
    • Bon : 5-10ms
    • Médiocre : 10-20ms
    • Mauvais : 20-100ms
    • Catastrophique : 100-500ms

    La latence, c’est ce que tes utilisateurs ressentent. Les IOPS impressionnent sur les fiches techniques, mais la latence tue l’expérience.


    Sources

  • SQL – Récupération en attente

    SQL – Récupération en attente

    Je me connecte sur un serveur SQL et j’ai un message d’erreur sur la majorité des bases.
    SQL - Récupération en attente - 1.png

    Après un redémarrage du serveur, j’ai 2 bases opérationnelles et toutes les autres sont en mode : récupération en attente.

    Je lance un script classique dans ces cas là :

    ALTER DATABASE [DBName] SET EMERGENCY;
    GO
    ALTER DATABASE [DBName] set single_user
    GO
    DBCC CHECKDB ([DBName], REPAIR_ALLOW_DATA_LOSS) WITH ALL_ERRORMSGS;
    GO
    ALTER DATABASE [DBName] set multi_user


    Et voilà le résultat

    Msg 945

    En lisant la longue Lituanie des erreurs Msg 945 : je pense qu’il s’agit soit d’un problème de disque, soit d’un problème de droit.

    Je contrôle le disque :

    • et la place disponible
    • pas d’erreur avec un CHKDSK,
    • donc c’est sans doute un problème de droit.

    Après un contrôle, c’est simplement un problème de droit pour l’utilisateur du service SQL Server.

    Je relance la vérification des bases.

    Résultats DBCC pour 'cap_sage'.
    Message Service Broker 9675, état 1 : Types de messages analysés : 14.
    Message Service Broker 9676, état 1 : Contrats de service analysés : 6.
    Message Service Broker 9667, état 1 : Services analysés : 3.
    Message Service Broker 9668, état 1 : Files d'attente du service analysées : 3.
    Message Service Broker 9669, état 1 : Points de terminaison de conversation analysés : 0.
    Message Service Broker 9674, état 1 : Groupes de conversation analysés : 0.
    Message Service Broker 9670, état 1 : Liaisons de service distant analysées : 0.
    Message Service Broker 9605, état 1 : Priorités de conversation analysées : 0.
    Résultats DBCC pour 'sys.sysrscols'.
    Il y a 15464 lignes dans 174 pages pour l'objet "sys.sysrscols".
    Résultats DBCC pour 'sys.sysrowsets'.
    Il y a 2114 lignes dans 21 pages pour l'objet "sys.sysrowsets".
    Etc.


    Source

    https://www.systoolsgroup.com/fr/recuperation-du-serveur-sql-en-attente